


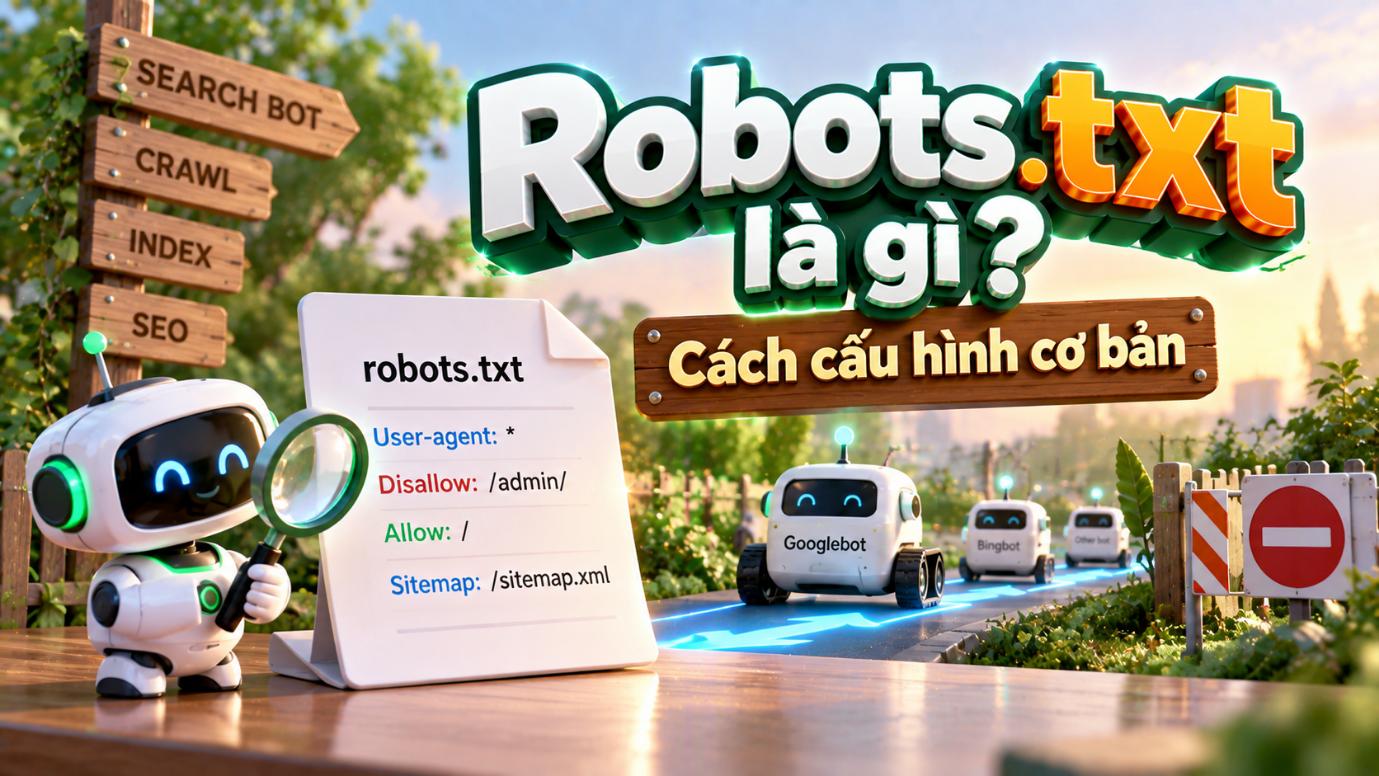
Robots.txt là gì?
robots.txt là file đặt tại thư mục gốc của website, ví dụ:
brand.com/robots.txt
File này hướng dẫn bot công cụ tìm kiếm được hoặc không được crawl những khu vực nhất định của website.
Cấu hình cơ bản
Ví dụ cho phép bot crawl toàn bộ website:
User-agent: *
Disallow:
Chặn một thư mục:
User-agent: *
Disallow: /admin/
Có thể khai báo thêm sitemap:
Sitemap: https://brand.com/sitemap.xml
Các thành phần chính
User-agent → xác định bot áp dụng quy tắc.
Disallow → khu vực không muốn bot crawl.
Allow → cho phép crawl một đường dẫn cụ thể trong khu vực bị hạn chế.
Sitemap → khai báo vị trí sitemap.
Robots.txt có chặn Google index không?
Không hoàn toàn.
robots.txt chủ yếu kiểm soát crawl, không phải công cụ chắc chắn để loại URL khỏi kết quả tìm kiếm.
Nếu muốn một trang không được index, nên sử dụng phương pháp phù hợp như noindex và vẫn cho bot truy cập trang để đọc chỉ thị đó.
Những lỗi cần tránh
Không nên:
- Chặn nhầm toàn bộ website.
- Chặn CSS hoặc JavaScript quan trọng.
- Dùng robots.txt để bảo vệ dữ liệu bí mật.
- Chặn URL rồi đồng thời mong Google đọc thẻ
noindextrên chính URL đó. - Quên kiểm tra robots.txt sau khi đưa website từ staging lên production.
Kết luận
Có thể ghi nhớ:
Robots.txt = hướng dẫn bot crawl website.
Cấu hình tốt nên:
chỉ chặn những khu vực thật sự không cần crawl và tránh chặn nhầm nội dung quan trọng.
Trước khi chỉnh sửa, nên kiểm tra kỹ vì chỉ một dòng cấu hình sai cũng có thể khiến công cụ tìm kiếm không truy cập được phần lớn website.